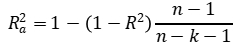二、练习题
1.根据表 12-1 的数据用 Excel 进行回归,并对回归结果进行讨论,计算 x1=200,x2=7 时 y 的预测值。
表 12-1
y | x1 | x2 |
12 | 174 | 3 |
18 | 281 | 9 |
31 | 189 | 4 |
28 | 202 | 8 |
52 | 149 | 9 |
47 | 188 | 12 |
38 | 215 | 5 |
22 | 150 | 11 |
36 | 167 | 8 |
17 | 135 | 5 |
解:由 Excel 输出的回归结果,如表 12-2、12-3 和 12-4 所示。
表 12-2回归结果
回归统计 |
Multiple R | 0.459234 |
R Square | 0.210896 |
Adjusted R Square | -0.01456 |
标准误差 | 13.34122 |
观测值 | 10 |
表 12-3方差分析
| df | SS | MS | F | Significance F |
回归分析 | 2 | 332.9837 | 166.4919 | 0.93541 | 0.436485 |
残差 | 7 | 1245.916 | 177.988 |
|
|
总计 | 9 | 1578.9 |
|
|
|
表 12-4
| Coefficients | 标准误差 | t Stat | P-value | Lower 95%% | Upper 95%% |
Intercept | 25.0287 | 22.27863 | 1.12344 | 0.298298 | -27.6519 | 77.70928 |
X Variable 1 | -0.04971 | 0.105992 | -0.46904 | 0.653301 | -0.30035 | 0.200918 |
X Variable 2 | 1.928169 | 1.47216 | 1.309755 | 0.231624 | -1.55294 | 5.409276 |
∧
所以回归方程为:y=25.0287-0.04971x1+1.928169x2。
∧ ∧
其中β1=-0.04971 表示,在 x2 不变的条件下,x1 每增加 1 个单位,y 平均下降 0.04971 个单位;β2=1.928169
表示,在 x1 不变的条件下,x2 每增加 1 个单位,y 平均增加 1.928169 个单位。
判定系数 R2=21.09%%,表示在因变量的变差中能够被 y 与 x1 和 x2 之间的线性关系所解释的比例为 21.09%%。 由于这一比例很低,表明回归方程的拟合程度很差。估计标准误差 se=13.34122,预测误差也较大。
方差分析表显示,Significance F=0.436485>α=0.05,表明 y 与 x1 和 x2 之间的线性关系不显著。用于回归 系数检验的 P 值均大于 α=0.05,两个回归系数均不显著。
∧
当 x1=200,x2=7 时,y 的预测值为:y=25.0287-0.04971×200+1.928169×7=28.58。
2.一家电器销售公司的管理人员认为,月销售收入是广告费用的函数,并想通过广告费用对月销售收入作 出估计。表 12-5 是近 8 个月的月销售收入与广告费用数据。
表 12-5销售额与广告费用
月销售收入 y(万元) | 电视广告费用 x1(万元) | 报纸广告费用 x2(万元) |
96 90 95 92 95 94 94 94 | 5.0 2.0 4.0 2.5 3.0 3.5 2.5 3.0 | 1.5 2.0 1.5 2.5 3.3 2.3 4.2 2.5 |
要求:
(1)用电视广告费用作自变量,月销售收入作因变量,建立估计的回归方程。
(2)用电视广告费用和报纸广告费用作自变量,月销售收入作因变量,建立估计的回归方程。
(3)上述(1)和(2)所建立的估计的回归方程,电视广告费用的系数是否相同?对其回归系数分别进行 解释。
(4)根据问题(2)所建立的估计的回归方程,在销售收入的总变差中,被估计的回归方程所解释的比例是 多少?
(5)根据问题(2)所建立的估计的回归方程,检验回归系数是否显著(α=0.05)。 解:(1)用电视广告费用作自变量,月销售收入作因变量,由 Excel 输出的回归结果如表 12-6、12-7 和 12-8
所示。
表 12-6回归结果
Multiple R | 0.807807 |
R Square | 0.652553 |
Adjusted R Square | 0.594645 |
标准误差 | 1.215175 |
观测值 | 8 |
表 12-7方差分析表
| df | SS | MS | F | Significance F |
回归分析 | 1 | 16.6401 | 16.6401 | 11.26881 | 0.015288 |
残差 | 6 | 8.859903 | 1.476651 |
|
|
总计 | 7 | 25.5 |
|
|
|
表 12-8
| Coefficients | 标准误差 | t Stat | P-value | Lower 95%% | Upper 95%% |
Intercept | 88.63768 | 1.582367 | 56.01588 | 2.17E-09 | 84.76577 | 92.50959 |
X Variable 1 | 1.603865 | 0.477781 | 3.356905 | 0.015288 | 0.434777 | 2.772952 |
∧
所以估计的回归方程为:y=88.63768+1.603865x1。
(2)用电视广告费用和报纸广告费用作自变量,月销售收入作因变量,由 Excel 输出的回归结果如表 12-9、
12-10 和 12-11 所示。
表 12-9回归结果
回归统计 |
Multiple R | 0.958663 |
R Square | 0.919036 |
Adjusted R Square | 0.88665 |
标准误差 | 0.642587 |
观测值 | 8 |
表 12-10方差分析表
| df | SS | MS | F | Significance F |
回归分析 | 2 | 23.43541 | 11.7177 | 28.37777 | 0.001865 |
残差 | 5 | 2.064592 | 0.412918 |
|
|
总计 | 7 | 25.5 |
|
|
|
表 12-11
| Coefficients | 标准误差 | t Stat | P-value | Lower 95%% | Upper 95%% |
Intercept | 83.23009 | 1.573869 | 52.88248 | 4.57E-08 | 79.18433 | 87.27585 |
X Variable 1 | 2.290184 | 0.304065 | 7.531899 | 0.000653 | 1.508561 | 3.071806 |
X Variable 2 | 1.300989 | 0.320702 | 4.056697 | 0.009761 | 0.476599 | 2.125379 |
∧
所以估计的回归方程为:y=83.23009+2.290184x1+1.300989x2。
(3)(1)和(2)所建立的估计的回归方程中,电视广告费用的系数不相同。
∧
在(1)的回归方程中,回归系数β1=1.603865 表示:电视广告费用每增加 1 万元,月销售收入平均增加 1.603865
万元;
∧
在(2)的回归方程中,回归系数β1=2.290184 表示:在报纸广告费用不变的条件下,电视广告费用每增加 1
万元,月销售收入平均增加 2.290184 万元。
(4)问题(2)中,R2=91.9036%%,Ra2=88.665%%,表明在销售收入的总变差中,被估计的回归方程所解释 的比例为 88.665%%。
(5)问题(2)中,β1 的 P-值 0.000653,β2 的 P-值=0.009761,均小于 α=0.05,故两个回归系数均显著。
3.某农场通过试验取得早稻收获量与春季降雨量和春季温度的数据如表 12-12 所示。 表 12-12早稻的收获量、春季降雨量和温度
收获量 y(kg/hm2) | 降雨量 x1(mm) | 温度 x2(℃) |
2250 3450 4500 6750 7200 7500 8250 | 25 33 45 105 110 115 120 | 6 8 10 13 14 16 17 |
要求:
(1)试确定早稻收获量对春季降雨量和春季温度的二元线性回归方程。
(2)解释回归系数的实际意义。
(3)根据你的判断,模型中是否存在多重共线性?
解:(1)由 Excel 输出的回归结果如表 12-13、12-14 和 12-15 所示。 表 12-13回归结果
Multiple R | 0.995651 |
R Square | 0.991321 |
Adjusted R Square | 0.986982 |
标准误差 | 261.431 |
观测值 | 7 |
表 12-14方差分析表
| df | SS | MS | F | Significance F |
回归分析 | 2 | 31226615 | 15613308 | 228.4445 | 7.53E-05 |
残差 | 4 | 273384.7 | 68346.19 |
|
|
总计 | 6 | 31500000 |
|
|
|
表 12-15
| Coefficients | 标准误差 | t Stat | P-value | Lower 95%% | Upper 95%% |
Intercept | -0.591 | 505.0042 | -0.00117 | 0.999122 | -1402.71 | 1401.526 |
X Variable 1 | 22.38646 | 9.600544 | 2.331791 | 0.080095 | -4.26892 | 49.04184 |
X Variable 2 | 327.6717 | 98.79792 | 3.316585 | 0.029472 | 53.3647 | 601.9787 |
所以早稻收获量对春季降雨量和春季温度的二元线性回归方程为:
∧
y=-0.5910+22.3865x1+327.6717x2
∧
(2)回归系数β1=22.3865 表示,在温度不变的条件下,降雨量每增加 1mm,小麦收获量平均增加
∧

22.3865kg/hm2;回归系数β =327.6717 表示,在降雨量不变的条件下,温度每增加 1℃,小麦收获量平均增加
327.6717kg/hm2。
(3)从降雨量和温度与收获量的关系看,两个变量与收获量之间都存在较强的关系,而且从表 12-15 的数 据来看,温度与降雨量之间也存在较强的关系,因此,模型中可能存在多重共线性。
4.一家房地产评估公司想对某城市的房地产销售价格(y)与地产的评估价值(x1)、房产估价(x2)和使 用面积(x3)建立一个模型,以便对销售价格作出合理预测。为此,它收集了 20 栋住宅的房地产评估数据,如 表 12-16 所示。
表 12-16房地产评估数据
房地产编号 | 销售价格 y(元/平方米) | 地产估价 x1(万元) | 房产估价 x2(万元) | 使用面积 x3(平方米) |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | 6890 4850 5550 6200 11650 4500 3800 8300 5900 4750 4050 4000 9700 4550 4090 8000 5600 3700 5000 2240 | 596 900 950 1000 1800 850 800 2300 810 900 730 800 2000 800 800 1050 400 450 340 150 | 4497 2780 3144 3959 7283 2732 2986 4775 3912 2935 4012 3168 5851 2345 2089 5625 2086 2261 3595 578 | 18730 9280 11260 12650 22140 9120 8990 18030 12040 17250 10800 15290 24550 11510 11730 19600 13440 9880 10760 9620 |
用 Excel 进行回归,回答下面的问题:
(1)写出估计的多元回归方程。
(2)在销售价格的总变差中被估计的回归方程所解释的比例是多少?
(3)检验回归方程的线性关系是否显著(α=0.05)。
(4)检验各回归系数是否显著(α=0.05)。
解:(1)由 Excel 输出的回归结果如表 12-17、12-18 和 12-19 所示。 表 12-17回归结果
Multiple R | 0.947362 |
R Square | 0.897496 |
Adjusted R Square | 0.878276 |
标准误差 | 791.6823 |
观测值 | 20 |
表 12-18方差分析表
| df | SS | MS | F | Significance F |
回归分析 | 3 | 87803505 | 29267835 | 46.69697 | 3.88E-08 |
残差 | 16 | 10028175 | 626760.9 |
|
|
总计 | 19 | 97831680 |
|
|
|
表 12-19
| Coefficients | 标准误差 | t Stat | P-value | Lower 95%% | Upper 95%% |
Intercept | 148.7005 | 574.4213 | 0.25887 | 0.799036 | -1069.02 | 1366.419 |
X Variable 1 | 0.814738 | 0.511989 | 1.591321 | 0.131099 | -0.27063 | 1.900105 |
X Variable 2 | 0.82098 | 0.211177 | 3.887646 | 0.001307 | 0.373305 | 1.268654 |
X Variable 3 | 0.135041 | 0.065863 | 2.050332 | 0.057088 | -0.00458 | 0.274665 |
所以估计的多元回归方程为:
∧
y=148.7005+0.8147x1+0.8210x2+0.1350x3
(2)判定系数 R2=89.75%%,调整的判定系数 Ra2=87.83%%,表明销售价格的总变差中,被估计的回归方程 所解释的比例为 87.83%%。
(3)由于 Significance F=3.88E-08<α=0.055,因此回归方程的线性关系显著。
(4)β1 的 P-值=0.1311>α=0.05,不显著;β2 的 P-值=0.0013≤α=0.05,显著;β3 的 P-值=0.0571>α=
0.05,不显著。
5.表 12-20 是随机抽取的 15 家大型商场销售的同类产品的有关数据(单位:元)。 表 12-20大型商场销售的同类产品的数据
企业编号 | 销售价格 y | 购进价格 x1 | 销售费用 x2 |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | 1238 1266 1200 1193 1106 1303 1313 1144 1286 1084 1120 1156 1083 1263 1246 | 966 894 440 664 791 852 804 905 771 511 505 851 659 490 696 | 223 257 387 310 339 283 302 214 304 326 339 235 276 390 316 |
要求:
(1)计算 y 与 x1、y 与 x2 之间的相关系数,是否有证据表明销售价格与购进价格、销售价格与销售费用之 间存在线性关系?
(2)根据上述结果,你认为用购进价格和销售费用来预测销售价格是否有效?
(3)用 Excel 进行回归,并检验模型的线性关系是否显著(α=0.05)。
(4)解释判定系数 R2,所得结论与问题(2)中是否一致?
(5)计算 x1 与 x2 之间的相关系数,所得结果意味着什么?
(6)模型中是否存在多重共线性?你对模型有何建议?
解:(1)由 Excel 的“CORREL”函数计算的系数
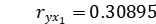
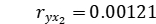
检验的统计量分别为:
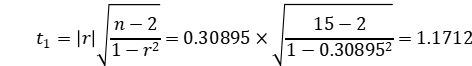
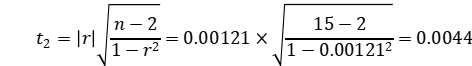
取 α=0.05,t0.05/2(15-2)=2.160。由于检验统计量 t1=1.1746<tα/2=2.160,t2=0.0044<tα/2 =2.106。因此 没有证据表明销售价格与购进价格、销售价格与销售费用之间存在线性关系。
(2)由于没有证据表明销售价格与购进价格、销售价格与销售费用之间存在线性关系,因此用购进价格和
销售费用来预测销售价格是没有用的。
(3)由 Excel 输出的回归结果,如表 12-21、12-22 和 12-23 所示。 表 12-21回归结果
Multiple R | 0.593684 |
R Square | 0.35246 |
Adjusted R Square | 0.244537 |
标准误差 | 69.75121 |
观测值 | 15 |
表 12-22方差分析表
| df | SS | MS | F | Significance F |
回归分析 | 2 | 31778.15 | 15889.08 | 3.265842 | 0.073722 |
残差 | 12 | 58382.78 | 4865.232 |
|
|
总计 | 14 | 90160.93 |
|
|
|
表 12-23
| Coefficients | 标准误差 | t Stat | P-value | Lower 95%% | Upper 95%% |
Intercept | 375.6018 | 339.4106 | 1.10663 | 0.290145 | -363.91 | 1115.114 |
X Variable 1 | 0.537841 | 0.210447 | 2.555711 | 0.0252 | 0.079317 | 0.996365 |
X Variable 2 | 1.457194 | 0.667707 | 2.182386 | 0.049681 | 0.002386 | 2.912001 |
所以回归方程为:
∧
y=375.6018+0.5378x1+1.4572x2
由于 Significance F=0.073722>α=0.05,线性关系不显著。

(4)R2=35.25%%,R 2=24.45%%,表明销售价格在总变差中,销售被估计的回归方程所解释的比例为 24.45%%, 说明线性关系不显著,所得结论与问题(2)一致。
(5)由 Excel 的“CORREL”函数计算的系数
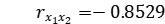
两个自变量高度负相关。
(6)由于两个自变量高度负相关,因此模型中存在多重共线性,建议将一个自变量从模型中剔除。