一、分类数据与 χ2 统计量
1.分类数据
按照所采用的计量尺度不同,可以将统计数据分为分类数据、顺序数据和数值型数据。分类数据和顺序数据 都是只能归于某一类别的非数字型数据,它们是对事物进行分类的结果,其结果均表现为类别,用文字来表述,不过顺序数据的类别是有序的;数值型数据是按数字尺度测量的观测值,其结果表现为具体的数值。
分类数据是对事物进行分类的结果,其特征是,调查结果虽然用数值表示,但不同数值描述了调查对象的不 同特征。数值型数据可以转化为分类数据。分类数据的结果是频数,χ2 检验是对分类数据的频数进行分析的统计方法。
2.χ2 统计量
χ2 统计量可以对分类数据做拟合优度检验和独立性检验,可以用于测定两个分类变量之间的相关程度。 若用 fo 表示观察值频数,用 fe 表示期望值频数,则 χ2 统计量可以写为:
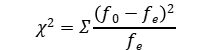
χ2 检验:χ2 检验是利用随机样本对总体分布与某种特定分布拟合程度的检验,也就是检验观察值与理论值之 间的紧密程度。χ2 检验主要用于拟合优度检验和独立性检验。
(1)χ2 统计量的特征
①χ2≥0,因为它是对平方值结果的汇总;
②χ2 统计量的分布与自由度有关;
③χ2 统计量描述了观察值与期望值的接近程度。两者越接近,即 f -f 的绝对值越小,计算出的 χ2 值越小;
o e
反之,fo-fe 的绝对值越大,计算出的 χ2 值也越大。χ2 检验正是通过对 χ2 的计算结果与 χ2 分布中的临界值进行比 较,做出是否拒绝原假设的统计决策。
(2)χ2 分布与自由度的密切关系
自由度越小,χ2 的分布就越向左边倾斜;随着自由度的增加,χ2 分布的偏斜程度趋于缓解,逐渐显露出对称 性,随着自由度的继续增大,χ2 分布将趋近于对称的正态分布。
(3)应用 χ2 检验统计量的注意事项
①各组的理论频数 fe 不得小于总频数 n;
②总频数应较大,至少大于 50;
③如果某组理论频数小于 5,可将相邻的若干组合并,直至理论频数大于 5 为止;
④倘若有两个以上的单元,如果 20%%的单元期望频数 fe 小于 5,则不能应用 χ2 检验。
二、拟合优度检验
拟合优度检验是利用样本信息对总体分布作出推断,检验总体是否服从理论分布(如均匀分布或二项分布)。
其方法是把样本分成 K 个互斥的类,然后根据要检验的理论分布算出每一类的期望频数,与实际的观察频数进 行比较,判断期望频数与观察频数是否有显著差异,从而达到对分类变量进行分析的目的。
拟合优度检验的步骤为:
(1)确定原假设与备择假设,原假设 H0 表示总体服从设定的分布;备择假设 H1,表示总体不服从设定的 分布。同时,确定显著性水平 α;
(2)从要研究的总体中,随机抽取一个观察值样本;
(3)按照“原假设为真”这一假定,导出一组期望频数或理论频数。通常这就是假定某概率分布适合于所 研究的总体;
(4)对观察频数与理论频数进行比较,如果它们之间的差异很大,以致在确定的显著性水平下不能把它归 之于随机波动,则拒绝原假设。
三、列联分析:独立性检验
拟合优度检验是对一个分类变量的检验,对于两个分类变量的分析,称为独立性检验,分析过程可以通过列 联表的方式呈现,故又可称为列联分析。
1.列联表
列联表是由两个以上的变量进行交叉分类的频数分布表。 表中的行是态度变量,表中的列是单位变量。将横向变量(行)的划分类别视为 R,纵向变量(列)的划分
类别视为 C,则可以把每一个具体的列联表称为 R×C 列联表。
2.独立性检验
独立性检验就是分析列联表中行变量和列变量是否相互独立。也就是检验行变量与列变量之间是否存在依赖
关系。独立性检验的特点在于其理论频数不是预先确定的,而需要从样本资料中获得。
四、列联表中的相关测量
可以用相关系数测定两个变量之间的相关程度,列联表中的变量通常是类别变量,它们表现研究对象的不同品质类别,这种分类数据之间的相关称为品质相关。
经常用到的品质相关系数有:φ 相关系数、列联相关系数、V 相关系数。
1.φ 相关系数
(1)概念
φ 相关系数是描述 2×2 列联表数据相关程度最常用的一种相关系数,其计算公式为:
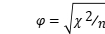
式中,
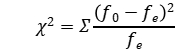
n 为列联表中的总频数,也即样本量。
(2)特点
①φ 系数适合 2×2 列联表,这是因为对于 2×2 列联表中的数据,φ 系数取值为 0~1。
②当 φ=0,表明两变量相互独立;当 φ=1,表明两变量完全相关。
注意:当列联表 R×C 中的行数 R 或列数 C 大于 2 时,φ 系数将随着 R 或 C 的变大而增大,且 φ 值没有上 限。这时用 φ 系数测定两个变量的相关程度就不够清晰,可以采用列联相关系数。
2.列联相关系数
(1)概念
列联相关系数又称列联系数,简称 c 系数,主要用于列联表大于 2×2 的情况,其计算公式为:
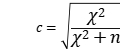
当列联表中的两个变量相互独立时,系数 c=0,但它不可能大于 1。
(2)特点
列联系数可能的最大值依赖于列联表的行数和列数,且随着 R 和 C 的增大而增大。计算简便,且对总体的 分布没有任何要求,列联系数是一种适应性较广的测度值。
(3)局限性
根据不同的行和列计算的列联系数不便于比较,除非两个列联表中行数和列数一致。
3.V 相关系数
(1)概念
V 相关系数的计算公式为:
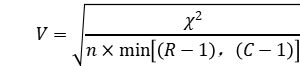
式中 min[(R-1),(C-1)]表示取(R-1),(C-1)中较小的一个。
(2)特点
当两个变量相互独立时,V=0;当两个变量完全相关时,V=1,所以 V 的取值在 0~1 之间。如果列联表 中有一维为 2,即 min[(R-1),(C-1)]=1,则 V 值就等于 φ 值。
4.数值分析
对于同一个数据,系数 φ,c,V 的结果不同。对于不同的列联表,行数和列数的差异也会影响系数值。因 此,在对不同列联表变量之间的相关程度进行比较时,不同列联表中行与行、列与列的个数要相同,并且采用同
一种系数,这样的系数值才具有可比性。
五、列联分析中应注意的问题
(1)一般来说,在列联表中变量的位置是任意的,既可以把变量 X 放在列的位置,也可以放在行的位置;
(2)如果变量 X 与 Y 存在因果关系,令 X 为自变量(原因),Y 为因变量(结果),一般自变量 X 放在列 的位置,条件百分表多按自变量的方向计算,这样可以更好地表现原因对结果的影响。但如果因变量在样本内的
分布不能代表其在总体内的分布,例如,为了满足分析的需要,抽样时扩大了因变量某项内容的样本量,这时仍 以自变量的方向计算百分表就会歪曲实际情况。在这种情况下,可以把计算百分表的方向变换一下,改为按因变 量方向计算,这样就能得到自变量对因变量比较真实的反映。