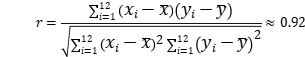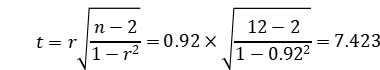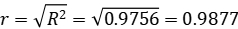
-
1 一、思考题
-
2 二、练习题
一、思考题
1.解释相关关系的含义,说明相关关系的特点。 答:变量之间存在的不确定的数量关系,称为相关关系。 相关关系的特点:一个变量的取值不能由另一个变量唯一确定,当变量 x 取某个值时,变量 y 的取值可能有几个。对这种关系不确定的变量是不能用函数关系进行描述的。
2.相关分析主要解决哪些问题? 答:相关分析就是对两个变量之间线性关系的描述与度量,它要解决的问题包括:
(1)变量之间是否存在关系;
(2)如果存在关系,它们之间是什么样的关系;
(3)变量之间的关系强度如何;
(4)样本所反映的变量之间的关系能否代表总体变量之间的关系。
3.相关分析中有哪些基本假定? 答:在进行相关分析时,对总体主要有以下两个假定:
(1)两个变量之间是线性关系;
(2)两个变量都是随机变量。
4.简述相关系数的性质。 答:相关系数是根据样本数据计算的度量两个变量之间线性关系强度的统计量。若相关系数是根据总体全部数据计算的,称为总体相关系数,记为 ρ;若是根据样本数据计算的,则称为样本相关系数,记为 r。
相关系数的性质:
(1)r 的取值范围在-1~+1 之间,即-1≤r≤1。若 0<r≤1,表明 x 与 y 之间存在正线性相关关系;若-1≤r<0,表明 x 与 y 之间存在负线性相关关系;若 r=+1,表明 x 与 y 之间为完全正线性相关关系;若 r=-1,表明 x 与 y 之间为完全负线性相关关系。可见当|r|=1 时,y 的取值完全依赖于 x,二者之间即为函数关系; 当 r=0 时,说明 y 的取值与 x 无关,即二者之间不存在线性相关关系。
(2)r 具有对称性。x 与 y 之间的相关系数 rxy 和 y 与 x 之间的相关系数 ryx 相等,即 rxy=ryx。
(3)r 数值大小与 x 和 y 的原点及尺度无关。改变 x 和 y 的数据原点及计量尺度,并不改变 r 数值大小。
(4)r 仅仅是 x 与 y 之间线性关系的一个度量,它不能用于描述非线性关系。这意味着,r=0 只表示两个 变量之间不存在线性相关关系,并不说明变量之间没有任何关系,它们之间可能存在非线性相关关系。变量之间
的非线性相关程度较大时,就可能会导致 r=0。因此,当 r=0 或很小时,不能轻易得出两个变量之间不存在相关关系的结论,而应结合散点图做出合理的解释。
(5)r 虽然是两个变量之间线性关系的一个度量,却不一定意味着 x 与 y 一定有因果关系。
5.为什么要对相关系数进行显著性检验?
答:一般情况下,总体相关系数 ρ 是未知的,通常是根据样本相关系数 r 作为 ρ 的近似估计值。但由于 r 是 根据样本数据计算出来的,它受到抽样波动的影响。由于抽取的样本不同,r 的取值也就不同,因此 r 是一个随 机变量。能否根据样本相关系数说明总体的相关程度,需要考察样本相关系数的可靠性,也就是进行显著性检验。
6.简述相关系数显著性检验的步骤。 答:相关系数显著性检验的步骤为:
(1)提出假设,H0:ρ=0;H1:ρ≠0。
(2)计算检验的统计量,
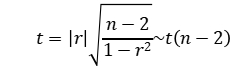
(3)进行决策。根据给定的显著性水平 α 和自由度 df=n-2 查 t 分布表,查出 tα/2(n-2)的临界值。若|t|
>tα/2,则拒绝原假设 H0,表明总体的两个变量之间存在显著的线性关系。
7.解释回归模型、回归方程、估计的回归方程的含义。 答:(1)回归模型:对于具有线性关系的两个变量,可以用一个线性方程来表示它们之间的关系。描述因变量 y 如何依赖于自变量 x 和误差项 ε 的方程称为回归模型。对于只涉及一个自变量的一元线性回归模型可表示为:
y=β0+β1x+ε。
(2)回归方程:根据回归模型中的假定,ε 的期望值等于 0,因此 y 的期望值 E(y)=β0+β1x,也就是说,y 的期望值是 x 的线性函数。描述因变量 y 的期望值如何依赖于自变量 x 的方程称为回归方程。一元线性回归方程的形式为:E(y)=β0+β1x。
(3)估计的回归方程:如果回归方程中的参数 β0 和 β1 已知,对于一个给定的 x 的值,利用式 E(y)=β0+β1x 就能计算出 y 的期望值。但总体回归参数 β0 和 β1 是未知的,必须利用样本数据去估计它们。用样本统计
∧ ∧
量β0 和β1 代替回归方程中的未知参数 β0 和 β1,这时就得到了估计的回归方程。它是根据样本数据求出的回归方程的估计。 对于一元线性回归,估计的回归方程形式为:
∧ ∧ ∧
y=β0+β1x
∧ ∧
式中,β0 是估计的回归直线在 y 轴上的截距;β1 是直线的斜率,表示 x 每变动一个单位时,y 的平均变动值。
8.一元线性回归模型中有哪些基本的假定? 答:一元线性回归模型中基本的假定:
(1)因变量 y 与自变量 x 之间具有线性关系。
(2)在重复抽样中,自变量 x 的取值是固定的,即假定 x 是非随机的。
(3)误差项 ε 是一个期望值为 0 的随机变量,即 E(ε)=0。
(4)对于所有的 x 值,ε 的方差 σ2 都相同。
(5)误差项 ε 是一个服从正态分布的随机变量,且独立,即 ε~N(0,σ2)。
9.简述参数最小二乘估计的基本原理。 答:对于第 i 个 x 值,估计的回归方程可表示为:
∧ ∧ ∧
y=β0+β1x
对于 x 和 y 的 n 对观察值,用于描述其关系的直线有多条,用距离各观测点最近的一条直线来代表两个变量 之间的关系,用最小化观测值与估计值的离差平方和来估计参数 β0 和 β1,根据这一方法确定模型参数 β0 和 β1
∧
的方法称为最小二乘法,也称为最小平方法,它是使因变量的观察值 yi 与估计值yi 之间的离差平方和达到最小来估计 β0 和 β1 的方法。
10.解释总平方和、回归平方和、残差平方和的含义,并说明它们之间的关系。
_
答:(1)总平方和(SST)是实际观测值 yi 与其均值y的离差平方和,即
_ ∧ ∧ _
SST=∑(yi-y)2=∑(yi-yi)2+∑(yi-y)2
∧ _ ∧ _
(2)回归平方和(SSR)是各回归值yi 与实际观测值的均值y的离差平方和,即 SSR=∑(yi-y)2,其反映了在 y 的总变差中由于 x 与 y 之间的线性关系引起的 y 的变化部分,它是可以由回归直线来解释的 yi 变差部分。
∧ ∧
(3)残差平方和(SSE)是各实际观测值 yi 与回归值yi 的离差平方和,即∑(yi-yi)2,它是除了 x 对 y 的
线性影响之外的其他因素对 y 变差的作用,是不能由回归直线来解释的 yi 变差部分。其又称为误差平方和。
(4)三者之间的关系:总平方和(SST)=回归平方和(SSR)+残差平方和(SSE)。
11.简述判定系数的含义和作用。
答:(1)判定系数的含义
回归平方和占总平方和的比例称为判定系数,记为 R2,其计算公式为: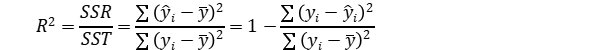
(2)判定系数的作用
判定系数 R2 测度了回归直线对观测数据的拟合程度。若所有观测点都落在直线上,残差平方和 SSE=0,R2=1,拟合是完全的;如果 y ∧的变化与 x 无关,x 完全无助于解释 y 的变差,此时y-y,则 R2=0。可见 R2 的取值范围是[0,1]。R2 越接近于 1,表明回归平方和占总平方和的比例越大,回归直线与各观测点越接近,用 x 的 变化来解释 y 值变差的部分就越多,回归直线的拟合程度就越好;反之,R2 越接近于 0,回归直线的拟合程度就越差。
12.在回归分析中,F 检验和 t 检验各有什么作用?
答:F 检验是检验自变量 x 和因变量 y 之间的线性关系是否显著,或者说,它们之间能否用一个线性模型 y=β0+β1x+ε 来表示,也就是线性关系的检验。
t 检验是检验自变量对因变量的影响是否显著,也就是回归系数的检验。
13.简要说明残差分析在回归分析中的作用。 答:残差分析在回归分析中的作用表现在:
(1)用于判断有关模型的假定是否成立;
(2)用于分析回归中的异常值和对模型有影响的观测值。