带你从数据的角度看《泰坦尼克号》的故事
背景:
泰坦尼克号(RMS Titanic),又译作铁达尼号,是英国白星航运公司下辖的一艘奥林匹克级游轮,排水量46000吨,于1909年3月31日在北爱尔兰贝尔法斯特港的哈兰德与沃尔夫造船厂动工建造,1911年5月31日下水,1912年4月2日完工试航。
泰坦尼克号是当时世界上体积最庞大、内部设施最豪华的客运轮船,有“永不沉没”的美誉 。然而不幸的是,在它的处女航中,泰坦尼克号便遭厄运——它从英国南安普敦出发,途经法国瑟堡-奥克特维尔以及爱尔兰科夫(Cobh),驶向美国纽约。1912年4月14日23时40分左右,泰坦尼克号与一座冰山相撞,造成右舷船艏至船中部破裂,五间水密舱进水。4月15日凌晨2时20分左右,泰坦尼克船体断裂成两截后沉入大西洋底3700米处。2224名船员及乘客中,1517人丧生,其中仅333具罹难者遗体被寻回。泰坦尼克号沉没事故为和平时期死伤人数最为惨重的一次海难,其残骸直至1985年才被再度发现,目前受到联合国教育、科学及文化组织的保护。
泰坦尼克号载有16艘木制救生艇和4个可折叠船,可容纳1178人,仅占泰坦尼克号总容量的三分之一(占旅客实际人数的53%)。 当时,救生艇的目的是将生还者从沉没的船运送到救援的船上,而不是让整个人口漂浮或上岸。 如果SS加利福尼亚号的人响应泰坦尼克号的遇险电话,则救生艇可能足以按计划将乘客运送至安全地点,但这并没有发生,唯一的生存方法就是登上救生艇。你可能存在疑问为什么救生船不够呢?事实是,当时国际通用的海事安全规则是,客船上的救生艇搭载人数是船上总人数的三分之一。灾难发生后,白星轮船公司极力辩解说,当时“泰坦尼克”号上共有 2224 人,而船上的救生艇能载 1178 人,完全符合法律要求,甚至还超标了。
那么问题来了,哪一类人在这样的重大灾难下有更多的生存机会?是社会结构力量较大,还是面临灾难时,人人机会均等呢?
#加载库
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import os
import time

#魔法函数 直接显示图
%matplotlib inline


import warnings
warnings.filterwarnings('ignore')

#加载数据
train_data =pd.read_csv('C:\\Users\\12434\\Data analysis\\data\\titanic_train.csv')

#打印数据结构 以及 数据前5行
print(train_data.shape)
train_data.head()
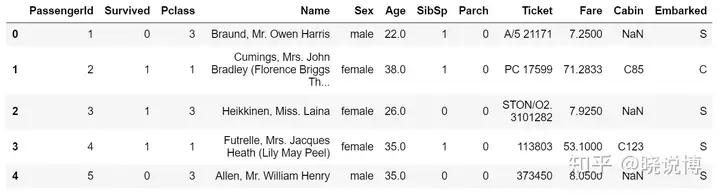
训练集数据包含891名乘客信息,15条变量信息。探究哪一部分的人有更大的生存概率问题是一个概率问题,所以此次只用训练集的891名乘客的信息作为样本数据分析,分析概率,而不是整体的乘客分析。
关于变量的信息:
PassengerId: 乘客编号
Survived: 存活情况(存活:1 ; 死亡:0)
Pclass : 客舱等级
Name : 乘客姓名
Sex : 性别
Age : 年龄
SibSp : 同乘的兄弟姐妹/配偶数
Parch : 同乘的父母/小孩数
Ticket : 船票编号
Fare : 船票价格
Cabin : 客舱号
Embarked: 登船港口
#变量的数据类型
train_data.info()
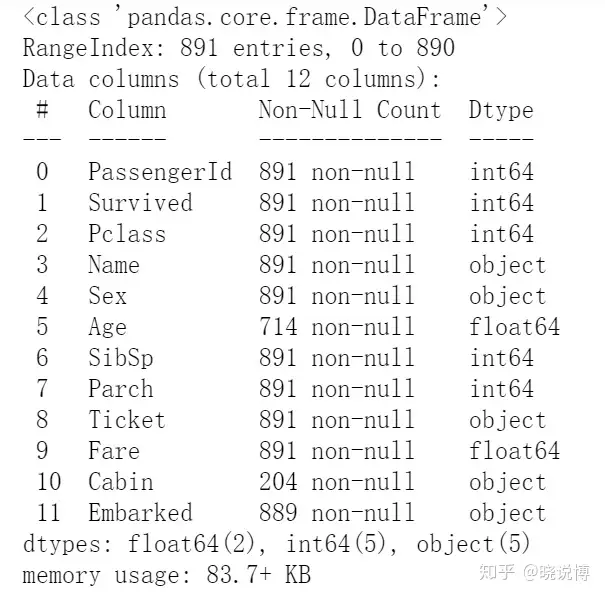
survived以及pclass 应该是分类数据,而不是整型,不过不影响整体的分析。
#筛选空值
train_data.isnull().sum()
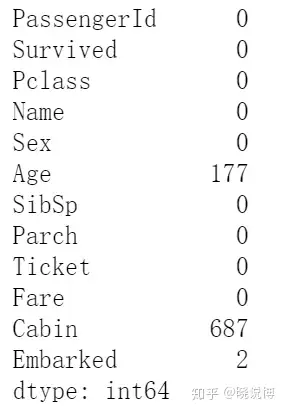
年龄数据缺失177个,船舱信息缺失687个,出发地缺失2个
'''
1、整体来看,存活比例如何?
要求:
① 读取已知生存数据train.csv
② 查看已知存活数据中,存活比例如何?
提示:
① 过程中筛选掉缺失值之后再分析
② 这里用seaborn制图辅助研究
'''
sns.set()
sns.set_style('ticks')
train_data['Survived'].value_counts().plot.pie(labels = ['downed','survived'],
explode=(0,0.05),shadow = True,autopct = '%.2f%%',fontsize=15)
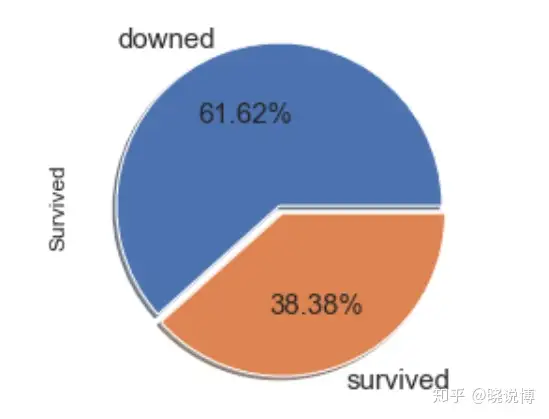
891名乘客中,幸存占比为38.38%,溺水占比61.62%
'''
2、结合性别和年龄数据,分析幸存下来的人是哪些人?
要求:
① 年龄数据的分布情况
② 男性和女性存活情况
③ 老人和小孩存活情况

'''

#年龄分布情况
fig,ax = plt.subplots(1,2,figsize=(15,7))
age = train_data[train_data['Age'].notnull()]
age['Age'].hist(bins=50,histtype='bar',edgecolor='k',ax=ax[0])

age['Age'].plot.box(showfliers=False,
                    color = {'boxes':'DarkGreen', 'whiskers':'DarkOrange', 'medians':'DarkBlue', 'caps':'Gray'},
                    grid=True,
                    ax=ax[1])
pd.DataFrame(age['Age'].describe()).transpose()
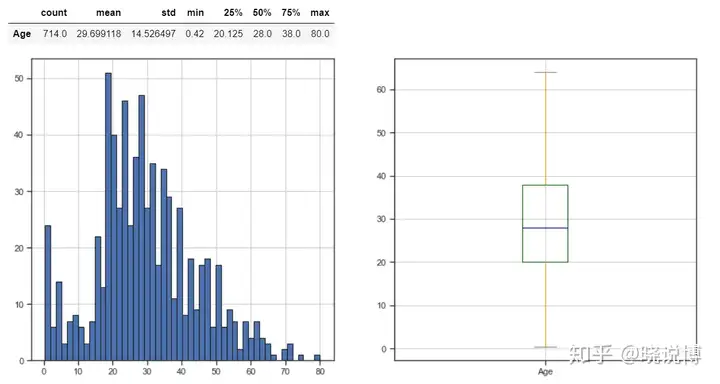
年龄分布呈现右偏,大部分数据集中在20岁到40岁之间,最小年龄是0.42,最大年龄是80。
#按照存活状态分布的年龄情况
plt.figure(figsize=(15, 3))
#显示汉字
plt.rcParams['font.sans-serif'] = ['SimHei']

sns.boxplot(y = 'Survived', x = 'Age', data = train_data,
     palette=["#3f3e6fd1", "#85c6a9"], fliersize = 0, orient = 'h')
#orient:"v"|"h" 用于控制图像使水平还是竖直显示
#fliersize:异常值大小

sns.stripplot(y = 'Survived', x = 'Age', data = train_data,
     linewidth = 0.6, palette=["#3f3e6fd1", "#85c6a9"], orient = 'h')

plt.yticks( np.arange(2), ['drowned', 'survived'],fontsize= 15)
plt.title('乘客的年龄分布情况',fontsize= 15)
plt.ylabel('存活状态')
plt.tight_layout()

pd.DataFrame(train_data.groupby('Survived').Age.describe())
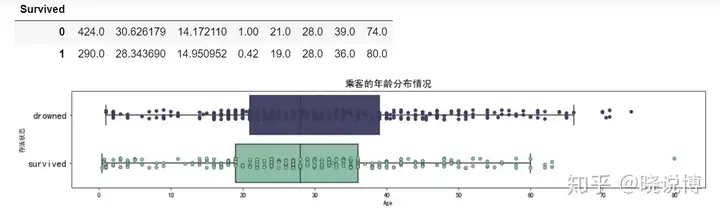
幸存者的年龄整体比溺水的年龄小,幸存者数据有一个明显的异常值,80岁的幸存者,需要检查一下。
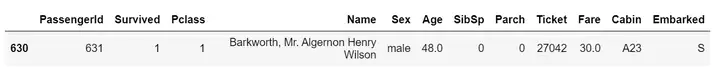
train_data[train_data['Age']==80]

事实上,白克华先生生於1864年6月4日,1912年48岁,1945年去世,享年80岁。可在泰坦尼克号网站查询。
#修正数据
train_data.loc[train_data['Age']==80,'Age'] = 48
train_data[train_data['Name']=='Barkworth, Mr. Algernon Henry Wilson']
#更新描述分析
pd.DataFrame(train_data.groupby('Survived').Age.describe())
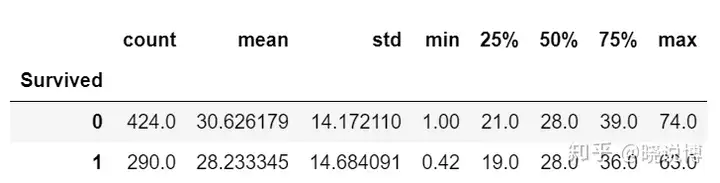
由此可以看出异常值没有造成很大的影响,结论依旧是年龄偏小的人群获救概率越大。
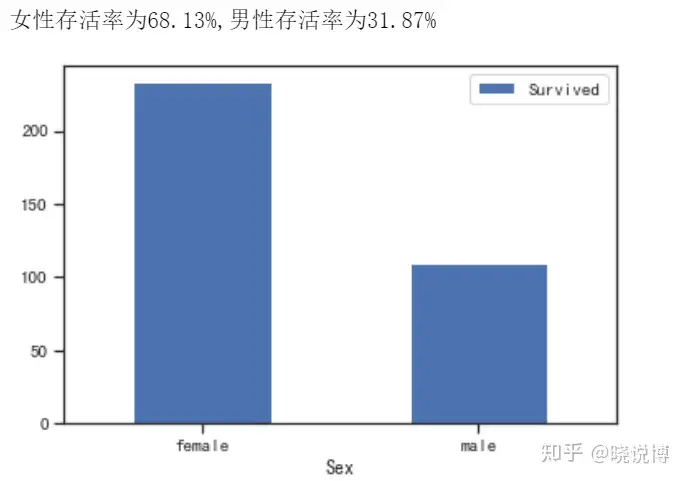
#男性和女性存活情况
s_sex = train_data[train_data['Survived']==1][['Sex','Survived']].groupby('Sex').count()

s_sex.plot.bar(rot=0)

print(
'女性存活率为%0.2f%%,男性存活率为%0.2f%%'
%(s_sex.loc['female']/s_sex.sum()*100,s_sex.loc['male']/s_sex.sum()*100))
#年龄与存活的关系
age = train_data[train_data['Age'].notnull()]
s_age = age[age['Survived']==1]

fig,ax = plt.subplots(1,3,figsize=(15,5))

sns.violinplot(x='Pclass',y='Age',hue='Survived',data = age,split=True,ax=ax[0],grid=True)
ax[0].set_yticks(range(0,110,10))


sns.violinplot('Sex','Age',hue='Survived',data=age,split=True,ax=ax[1])
ax[1].set_yticks(range(0,110,10))

sns.violinplot('Pclass','Age',hue='Sex',data=s_age,split=True,ax=ax[2])
ax[2].set_yticks(range(0,110,10))

plt.tight_layout()
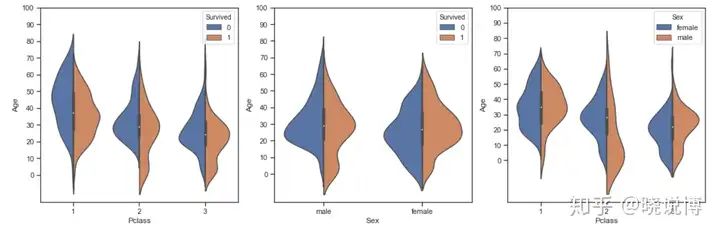
按照不同船舱等级划分: 船舱等级越高,存活者年龄越大,船舱等级1存活年龄集中在20-40岁,船舱等级2/3中有较多低龄乘客存活
按照性别划分 : 男性女性存活者年龄主要分布在20-40岁,且均有较多低龄乘客,其中女性存活更多
按照不同船舱等级看存活的男女比例: 1、3等舱存活的男性大部分为20到50,2等舱幸存男性年龄偏低
age = train_data[train_data['age'].notnull()]
age['age_int']=age['age'].astype(int)
a = age[['survived','age_int']].groupby('age_int',as_index=False).mean()
#计算均值相当于计算存活率

plt.figure(figsize=(15,4))
sns.barplot(x ='age_int',y='survived',data=a, palette = 'BrBG')
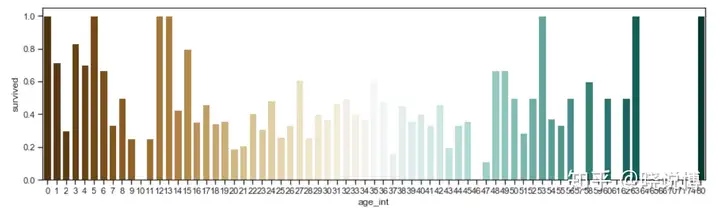
较小年纪与较大年纪的存活率较高
'''
3、结合 SibSp、Parch字段,研究亲人多少与存活的关系
要求:
① 有无兄弟姐妹/父母子女和存活与否的关系
② 亲戚多少与存活与否的关系

'''
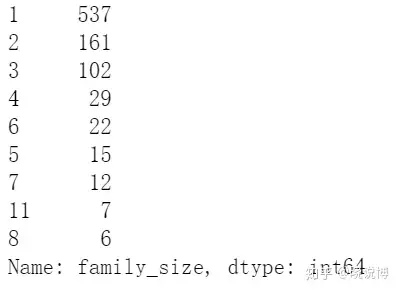
#计算家庭大小
train_data['family_size']=train_data['SibSp']+train_data['Parch']+1
train_data['family_size'].value_counts()
#家庭大小与存活的关系
fig = plt.figure(figsize=(12,5))

ax1 = fig.add_subplot(121)

ax = sns.countplot(train_data['family_size'])
labels = (train_data['family_size'].value_counts())
for i, v in enumerate(labels):
    ax.text(i, v+6, str(v), horizontalalignment = 'center', size = 10, color = 'black')
plt.ylabel('乘客数')
plt.title('按照家庭数量分布的乘客情况')

ax2 = fig.add_subplot(122)

a = train_data.groupby('family_size')['Survived'].value_counts(normalize=True).unstack()
a.plot(kind='bar',stacked='True',color=["#3f3e6fd1", "#85c6a9"],rot=0,ax =ax2)
plt.legend(( 'Drowned', 'Survived'), loc=(1.04,0))
plt.title('按照家庭数量分布的存活情况')
plt.tight_layout()
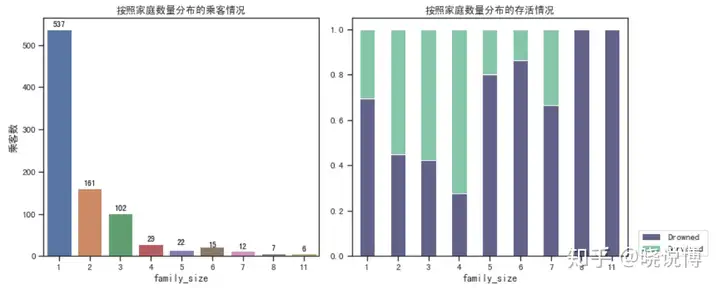
有两个大小分别为8和11的大家族,其训练数据集中的所有成员均被淹死。
大多数乘客独自旅行,生存率不是很高。
在船上有4位家庭成员的人群中,幸存的乘客比例最大。
'''
4、结合票的费用情况,研究票价和存活与否的关系
要求:
① 票价分布和存活与否的关系
② 比较研究生还者和未生还者的票价情况

'''
# 票价分布和存活与否的关系

fig, ax=plt.subplots(1,2,figsize=(15,4))
train_data['Fare'].hist(bins=70, ax = ax[0])
train_data.boxplot(column='Fare', by='Pclass', showfliers=False,ax = ax[1])
# 查看票价分布情况

fare_not_survived = train_data['Fare'][train_data['Survived'] == 0]
fare_survived = train_data['Fare'][train_data['Survived'] == 1]
# 基于票价,筛选出生存与否的数据
average_fare = pd.DataFrame([fare_not_survived.mean(),fare_survived.mean()])
std_fare = pd.DataFrame([fare_not_survived.std(),fare_survived.std()])
average_fare.plot(yerr=std_fare,kind='bar',legend=False,figsize = (15,4),grid = True)
# 查看票价与是否生还的关系
plt.tight_layout()
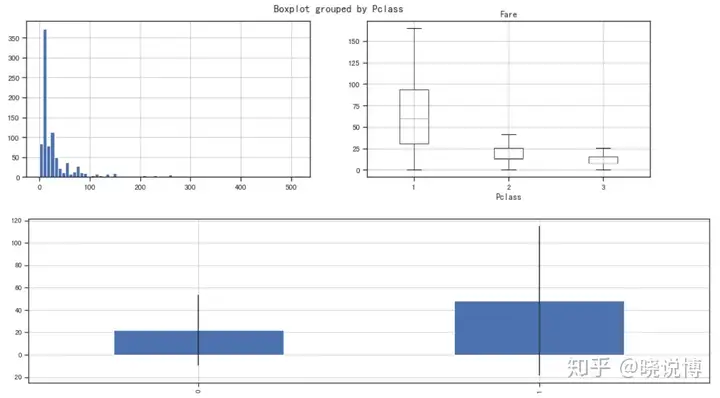
生还者的平均票价要大于未生还者的平均票价
'''
5、结合出发地的情况,研究出发地点与存活的关系

'''
fig = plt.figure(figsize = (15,4))

ax1 = fig.add_subplot(131)
palette = sns.cubehelix_palette(5, start = 2)
ax = sns.countplot(train_data['Embarked'], palette = palette, order = ['C', 'Q', 'S'], ax = ax1)
plt.title('不同港口出发的乘客分布情况')
plt.ylabel('乘客数')


labels = (train_data['Embarked'].value_counts())
labels = labels.sort_index()

for i, v in enumerate(labels):
    ax.text(i, v+10, str(v), horizontalalignment = 'center', size = 10, color = 'black')


ax2 = fig.add_subplot(132)
surv_by_emb = train_data.groupby('Embarked')['Survived'].value_counts(normalize = True)
surv_by_emb = surv_by_emb.unstack().sort_index()
surv_by_emb.plot(kind='bar', stacked='True', color=["#3f3e6fd1", "#85c6a9"], ax = ax2)
plt.title('不同港口出发的乘客存活情况')
plt.legend(( 'Drowned', 'Survived'), loc=(1.04,0))
_ = plt.xticks(rotation=False)


ax3 = fig.add_subplot(133)
class_by_emb = train_data.groupby('Embarked')['Pclass'].value_counts(normalize = True)
class_by_emb = class_by_emb.unstack().sort_index()
class_by_emb.plot(kind='bar', stacked='True', color = ['#eed4d0', '#cda0aa', '#a2708e'], ax = ax3)
plt.legend(('1st class', '2nd class', '3rd class'), loc=(1.04,0))
plt.title('不同港口出发的乘客的船舱等级分布')
_ = plt.xticks(rotation=False)

plt.tight_layout()
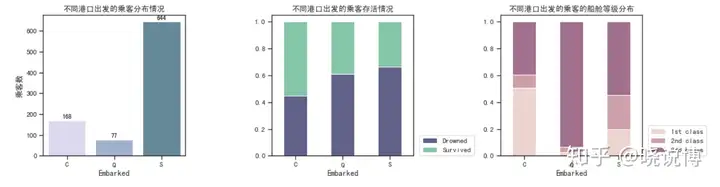
大多数乘客登上南安普敦。 南安普敦的溺水乘客比例最大。
从瑟堡出发的乘客,其中50%以上存活(在训练数据集中)。
皇后镇出发的乘客中,绝大多数是三等舱乘客。
6.结论
我们知道泰坦尼克号上没有足够的船只可供所有乘客撤离。 在研究了有关乘客的信息之后,我们可以对谁在沉船事故中有更好的生存机会以及对乘客的一般观察做出一些假设。
数据集中有891名乘客,其中有549名(61.6%)被淹,只有342名(38.4%)幸存。 但是我们知道,救生艇(16艘木质救生艇和4辆可折叠救生艇)可以载运总乘客的53%。
所有乘客的年龄从0.17年到80岁不等,平均为29.88岁。 幸存乘客的平均年龄为28.23,比溺水乘客的平均年龄(仅我们知道幸存者的年龄)小2.39。 看起来年轻人有更大的生存机会。
船上的家庭人数似乎也对生存机会有影响:有两个大家庭,分别为8和11,他们来自训练数据集的所有成员都被淹死了。 我们可以观察到,拥有2人,3人,4人家庭的幸存者所占百分比大于单身人士,然后,随着家庭规模的增加,幸存者所占的百分比会降低。
泰坦尼克号的大部分乘客都是三等舱。 就乘客人数而言,第二类是最小的。 尽管有先前确定的先决条件(平均而言,老年人死亡的可能性更高,并且头等舱的平均年龄比其他舱位更高。而且,由100%头等舱组成的A层乘客的 溺水乘客的比例很高),头等舱的幸存者人数最多,而舱内幸存者的比例最大。
三等舱机票的溺水乘客人数最多。但是,大多数头等舱的男性乘客被淹死,而女性几乎全部幸存下来。 三等舱,一半的女性得以幸存。
船上的男性总体上比女性多,这对每个舱位来说都是公平的,但是在三等舱中,男性的数量是女性的两倍多。
几乎有600名男性旅客没有家庭成员,只有200名女性,但是在普通家庭和大家庭中,女性旅客略多。
大多数乘客(914)登上南安普敦。 此外,南安普敦的溺水乘客比例最大。 270名乘客登上瑟堡,其中50%以上幸存下来(在培训数据集中)。 皇后镇(Queenstown)出发的旅客有123人,其中绝大多数是三等舱旅客。
泰坦尼克号幸存者分析是机器学习的入门案例,我做了一点资料的查询发现有一些是数据无法体现的,不得不说单从数据的角度还原当时情况实在有很多不妥的地方,原因有以下几点:
三等舱乘客中相当一部分是不懂英语的,看不懂路标指示,听不懂船员的指令。这一因素与社会地位无关。
爱德华·约翰·史密斯船长在最后时刻下令“妇孺优先”,但是大副、二副对该命令的执行是不一致的,右舷大副默多克认为如果甲板上没有女士儿童了,只要还有空位,男性乘客也可以登艇。所以从右舷放下的九艘救生艇上都有男性乘客,救生艇的乘坐率也比较高,其中有三艘满员。而在左舷的二副莱托勒则把“女士和儿童优先”理解为“全船的女士和儿童都应当先于男性乘客登艇”。所以,左舷的救生艇其实是“仅限女士和儿童”。从左舷放下的九艘救生艇中,只有三艘乘坐率略超过六成。
考察头等舱幸存男性,他们主要集中右舷最早放下的三艘救生艇中,第一艘救生艇,一半座位是空的,一半乘客是男性,主要原因是一开始多数人都没有认识到被认为“永不沉没”的铁达尼所面临的的危险。第二艘、第三艘救生艇男性乘客也占了近三分之一。还有一个原因是,右舷的救生艇位置距离头等舱近。
有少部分人主动放弃等艇机会,这样行为无疑闪烁着人性光辉。

