-
1 一维数据聚类
-
2 二维数据聚类
-
3 高维数据聚类
一、实验目的
1.通过该实验学习,使学生理解掌握RFM模型的基本概念;
2.掌握利用RFM模型对客户进行分类,区分无价值客户、高价值客户。
二、实验知识准备
RFM模型是衡量客户价值和客户创利能力的重要工具和手段。在众多的客户关系管理(CRM)的分析模式中,RFM模型是被广泛提到的。该机械模型通过一个客户的近期购买行为、购买的总体频率以及花了多少钱3项指标来描述该客户的价值状况。
R:最近一次消费,是指上一次购买的时间——顾客上一次是何时来店里、什么时候买的车,或在你的超市买早餐最近的一次是什么时候。
理论上,上一次消费时间越近的顾客应该是比较好的顾客,对提供即时的商品或是服务也最有可能会有反应。营销人员若想业绩有所成长,只能靠偷取竞争对手的市场占有率,而如果要密切地注意消费者的购买行为,那么最近的一次消费就是营销人员第一个要利用的工具。历史显示,如果我们能让消费者购买,他们就会持续购买。这也就是为什么,0至3个月的顾客收到营销人员的沟通信息多于3至6个月的顾客。
F:消费频率是顾客在限定的期间内所购买的次数。我们可以说最常购买的顾客,也是满意度最高的顾客。如果相信品牌及商店忠诚度的话,最常购买的消费者,忠诚度也就最高。增加顾客购买的次数意味着从竞争对手处偷取市场占有率,由别人的手中赚取营业额。
M:消费金额是所有数据库报告的支柱,也可以验证“帕雷托法则”(Pareto’s Law)——公司80%%的收入来自20%%的顾客。它显示出排名前10%%的顾客所花费的金额比下一个等级者多出至少2倍,占公司所有营业额的40%%以上。
理论上M值和F值是一样的,都带有时间范围,指的是一段时间(通常是1年)内的消费金额,对于一般店铺的类目而言,产品的价格带都是比较单一的,比如:同一品牌美妆类,价格浮动范围基本在某个特定消费群的可接受范围内,加上单一品类购买频次不高,所以对于一般店铺而言,M值对客户细分的作用相对较弱。
三、实验内容与步骤
实验背景: 某跨境卖家采集了近180天的客户消费记录数据。为了能更好的提高店铺的复购率,需要基于客户的交易情况等等,对客户进行细分,从而判别客户属于哪种类型,挖掘出具有发展潜能的客户,从而制定更为精准的营销策略。客户类型要求分成八类,即重要发展客户、重要价值客户、重要挽留客户、重要保持客户、一般价值客户、一般保持客户、一般发展客户、潜在客户。数据采集日期定在2018年11月8日。
1.数据准备
首先将本实训用到的数据导入【关系数据源】中,然后新建实验,保存之后从左边数据源中拖拽“关系数据源”到中间“画布区”,并在右边参数区根据自己上传数据的对应路径找到数据表,如图1所示。
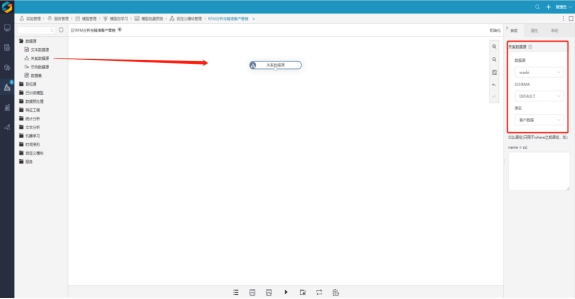
图1 数据准备
执行之后,在“关系数据源”节点鼠标右键单击,选择查看输出,即可查看本数据源详细数据,如图2所示。这是某跨境卖家采集的近180天的客户消费记录数据,共667条数据。在消费交易数据中共包含28个字段,主要字段有:OrderNumber、OrderAmount、Ordertime、Paymenttime、EndTime、BuyerName、Buyer country等等。
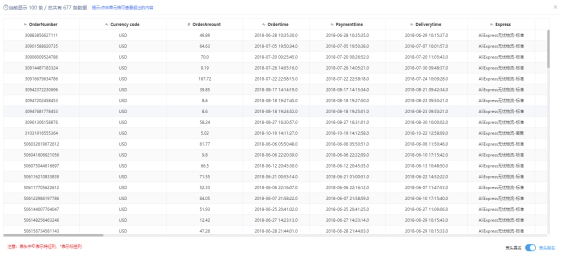
图2 查看详细数据
2.列选择
在RFM模型中需要用到三个指标为最近一次消费间隔、消费频率和消费金额,这三项指标来描述该客户的价值状况。最近一次消费间隔,可通过“Paymenttime”和“EndTime”这两个字段进行简单计算得到该生成列;消费频率,即客户在这一年中进行购买的次数,可通过聚合思想对“BuyerName”重复出现次数进行统计计算;订单金额总额,即将数据源中的“Paymenttime”字段进行总和计算。这里我们首先使用【列选择】节点将有用字段选出来,拖拽【列选择】,如图3所示。
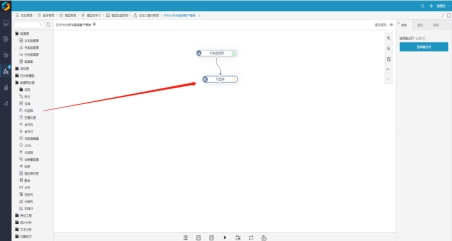
图3 列选择
点击右边参数区的“选择输出列”,将有用字段“OrderNumber”、“OrderAmount”、“Paymenttime”、“BuyerName”、“EndTime”选中后,点击“到右边”后确定为选择的输出列,如图4所示。
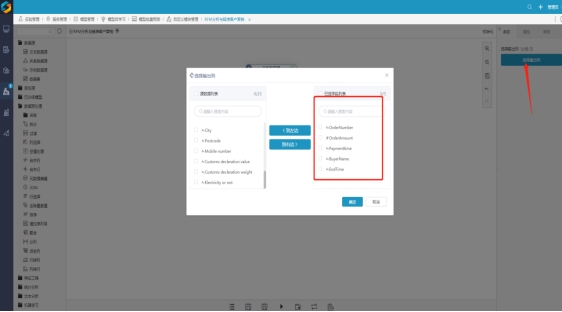
图4 选择输出列
运行成功后,右键查看输出,如图5所示。
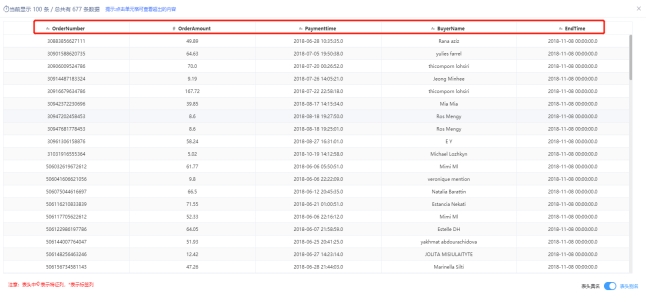
图5 列选择输出
3.元数据编辑
基于RFM模型对指标的要求,需要通过对“Paymenttime”和“EndTime”这两个字段进行减法计算即得到生成列“Recency”,减法表达式所需字段格为“String”。因此,我们选择【元数据编辑】对“EndTime”和“BuyerName”两个字段的数据类型跟改为string类型,首先拖拽【元数据编辑】节点,如图6所示。
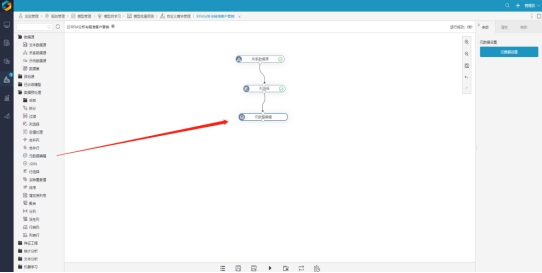
图6 元数据编辑
点击“元数据设置”,对相关字段的数据类型修改如图7所示。
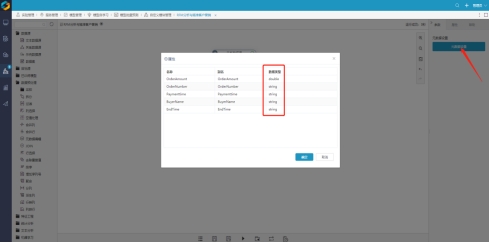
图7 元数据设置
4.创建派生列
我们选择【派生列】添加表达式,如图8所示。
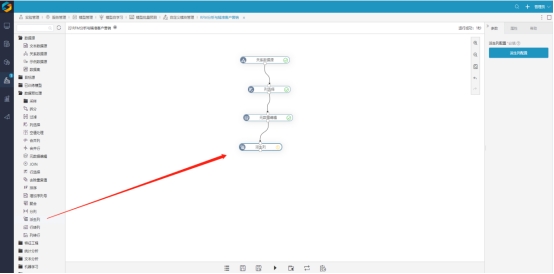
图8 派生列
应注意的是表达式的格式为datediff(string enddate,string startdate),意义为计算开始时间startdate到结束时间enddate相差的天数。派生列名为“Recency”的表达式如下图9所示,输出生成的派生列“Recency”字段如下图10所示。
注:表达式中的字段名称可通过双击左边菜单栏中对应的字段获取,输入表达式后要点击下方的“确定”按钮,直至下方出现表达式。
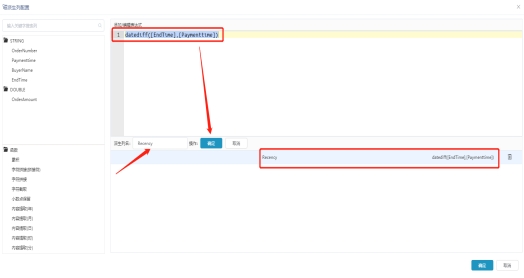
图9 添加派生列表达式
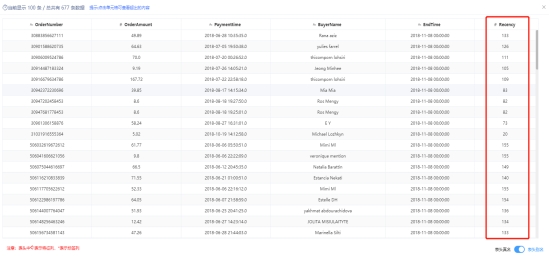
图10 派生列输出
5.聚合
我们选择【聚合】,将各字段根据需求进行相关聚合运算,如图11所示。
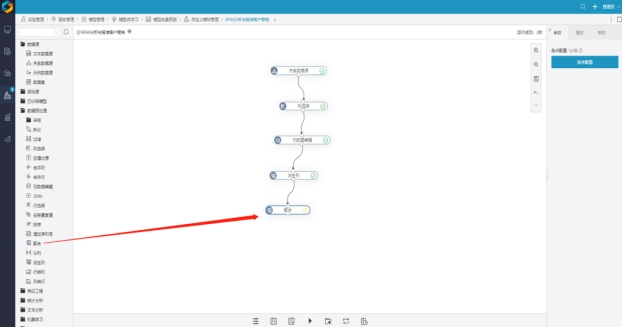
图11 聚合
聚合配置如图12所示。首先将“BuyerName”进行计数,生成的列名为“Group_ BuyerName”,之后再将“BuyerName”字段进行分组,生成列名为“Group_BuyerName”,将结果列名自定义为“Frequency”方便之后观察。
由于R值越小表示客户在该店消费的时间越近,即最近有购买行为的客户是复购可能性越高的有价值客户。于是我们将“Recency”字段进行最小值操作,生成列名为“Min_Recency”,并将其列名自定义为“Recency”。
最后我们将交易金额值进行汇总,生成列名为“Sum_OrderAmount”,将其列名自定义为“Monetary”。
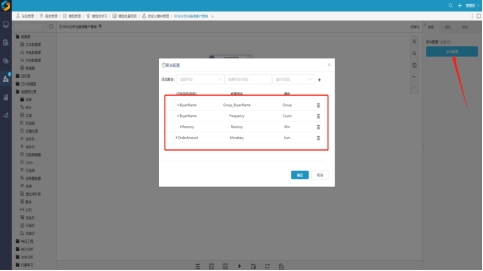
图12 聚合配置
聚合结果如图13所示。
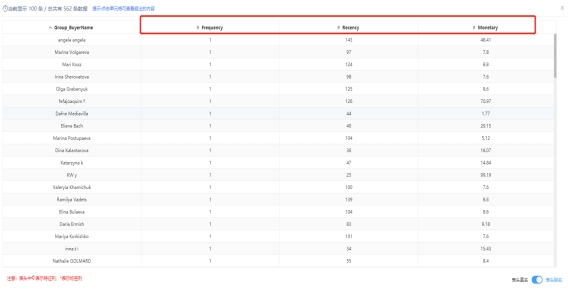
图13 聚合输出
6.RFM模型建立
完成三项指标的聚合配置后,最后一步就是运用RFM模型对进行客户分类。
在【统计分析】中选择【RFM】模型,如图14所示。
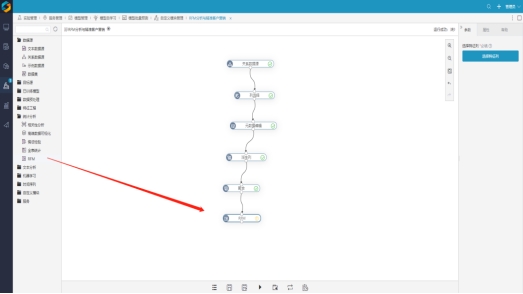
图14 “RFM”模型
进行【选择特征列】操作。注意:先选择的字段权值更大。
根据RFM指标顺序:R值、F值、M值,对应为 “Recency”字段、“Frequency”字段、“Monetary”字段,三个字段均指定为均值进行配置,如图15所示。输出结果如图16所示,划分结果生成两个标签BinaryRFMClass和RFMClass。RFM模型根据每个指标数据的均值,通过将每位客户的三个指标与均值进行比较,若对应字段取值小于均值时,权值为取0,否则取1。RFMClass为BinaryRFMClass其根据二进制取值转换成十进制取值。
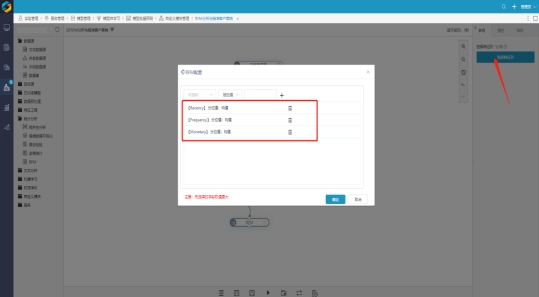
图15 RFM配置
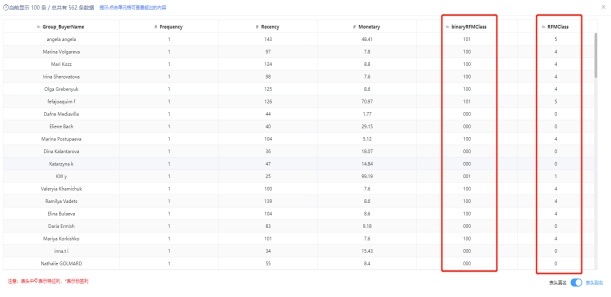
图16 RFM模型划分结果
工作流整体如图17所示。需注意的步骤为派生列、聚合和最后的RFM建模配置。理解模型指标含义和明确聚合所要达到的效果是至关重要的。
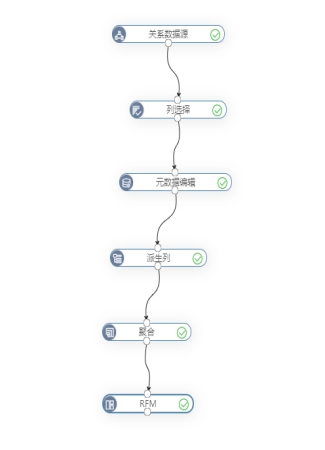
图17 工作流整体
通过将每位客户三个指标与均值进行比较,可将客户按价值细分为八种类型:高价值客户、重点保持客户、重点发展客户、重点挽留客户、一般价值客户、一般保持客户、一般发展客户、潜在客户,具体分类标准如表1所示。
表1 RFM分类表
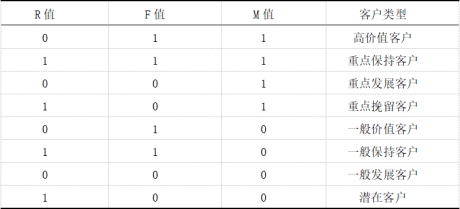
在RFM模型分析中,我们已经得到模型划分结果,将BinaryRFMClass列的权值对应表1 RFM分类表,可得出案例中各种客户所属类型,以此挖掘出有发展潜能的客户,从而制定更为精准的营销策略。
四、实验要求
1.了解RFM模型相关概念;
2.掌握案例操作,理解模型含义。
五、思考题
1.思考客户平均客单价、客户复购周期、客户平均购买频次这三组数值在设置RFM参数时有何意义。
2.根据本案例结果,设计针对各部分客户的营销活动。

